Domain sesamöl.de kaufen?
Wir ziehen mit dem Projekt
sesamöl.de um.
Sind Sie am Kauf der Domain
sesamöl.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain sesamöl.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Küllmer, Katharina: Soulfood - Vegan, gesund und glücklichSoulfood - Vegan, gesund und glücklich , Das aromenreiche Kochbuch mit 120 Rezepten , Zündvorrichtungen > Zünd- & Glühanlagen , Erscheinungsjahr: 20231017, Produktform: Leinen, Autoren: Küllmer, Katharina, Seitenzahl/Blattzahl: 303, Keyword: Aromenfeuerwerk; Foodfotografie; Gemüse; Gemüseküche; Geschmacksexplosion; Kochbuch vegan; Obst; Plant based Buch; Plant based Kochbuch; Regenbogenküche; Soulfood; aromenreich; aufwändig kochen; besondere Aromen; besondere Kochbücher; besonders kochen; bunt kochen; comfort food; delicious; gesund Kochen; gesunde Ernährung; gesunde Rezepte; katharinaküllmer; kein Fisch; kein Fleisch; laktosefrei; lecker vegan; mit Obst kochen; new cooking; no fish; no meat; pflanzenbasiert; pflanzenbasierte Ernährung; plant based; slow baking; slow cooking; vegan; vegan lecker; vegan und gesund; vegane Ernährung; veganer Genuss; veganes kochbuch, Fachschema: Kochen / Allgemeines Kochbuch, Grundwissen~Kochen / Biologisch, alternativ, Trennkost, Vollwertkost~Kochen / vegetarisch, vegan~Veganismus - vegan, Fachkategorie: Kochen: Gesundheit und Vollwertkost~Organic food / organic cookery~Kochen: Rezepte und Anleitungen, Warengruppe: HC/Themenkochbücher, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 297, Breite: 231, Höhe: 30, Gewicht: 1910, Produktform: Gebunden, Genre: Sachbuch/Ratgeber,42,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Sesamöl bioDas Sesamöl bio wirkt umhüllend, kräftigend und wärmend für sensible Menschen. Es unterstützt die Schutzwirkung der Haut, hilft den Wärmehaushalt des Körpers zu halten und ist ein sehr gutes Massageöl für Wohlfühl-Massagen. Sesamöl dient als bewährtes Hautöl für verschiedene Kuranwendungen im Ayurveda. Unser Sesamöl ist kaltgepresste, naturbelassene Bio Qualität. Die mögliche natürliche Trübung ist ein Zeichen von Naturbelassenheit des Öls.8,91 €*Versand: 3,90 €Sichere Weiterleitung zum Anbieter



-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **


Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
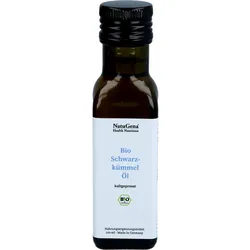
Bio Schwarzkümmelöl Kaltgepresst Vegan 100 MLProdukteigenschaften: Bezeichnung: Nahrungsergänzungsmittel - Bio Schwarzkümmel Öl Verwendung/Anwendung/Verzehrempfehlung: 1 x täglich Täglich 1 Teelöffel über kalte Speisen oder Salate geben oder direkt verzehren. Nährwertdeklaration: Nährwerte pro 100 ml Energie 3400 kJ / 827 kcal Fett 91,9 g o gesättigte Fettsäuren 14,8 g o einfach ungesättigte Fettsäuren 21,4 g o mehrfach ungesättigte Fettsäuren 56 g Kohlenhydrate, davon: 0,0 g o Zucker 0,0 g Eiweiß 0,0 g Salz 0,0 g * Referenzmenge für die tägliche Zufuhr gemäß EU-Verordnung 1169/2011. ** Keine Angaben vorhanden. Zutaten: Schonend kaltgepresstes Schwarzkümmelöl in Bio-Qualität. Allergene: keine Nettofüllmenge: 100 ml Aufbewahrungsbedingungen: Verschlossen, kühl, trocken und lichtgeschützt lagern. Ursprungsland des Lebensmittels: Deutschland Anschrift des Herstellers: NatuGena GmbH Münchener Str.149 85051 Ingolstadt Deutschland Telefon: ჽ 841 13 80 69 80 Telefax: ჽ 841 13 80 69 89 Mail: info@natugena.de Web: www.natugena.de Weitere Hinweise: Nicht für Kinder geeignet. Schwarzkümmelöl enthält viele wichtige Vitamine, Mineralstoffe und Ballaststoffe sowie ätherische Öle, darunter Thymoquinon. Nur Nährstoffe (keine Hilfsstoffe, keine Farbstoffe, laut Gesetz keine Konservierungsstoffe, keine technologischen Zusätze wie Binde- und Trennmittel, keine versteckten Zusatzstoffe, frei von Gluten, Geschmacksverstärkern, Lactose, Aromen, Soja). Die angegebene empfohlene tägliche Verzehrsmenge darf nicht überschritten werden. Nahrungsergänzungsmittel sind kein Ersatz für eine ausgewogene und abwechslungsreiche Ernährung und gesunde Lebensweise. Für kleine Kinder unzugänglich aufbewahren. Quelle: www.natugena.de und Angaben der Packungsbeilage Stand: 02/202618,95 €*Versand: 4,99 €Sichere Weiterleitung zum Anbieter
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Küllmer, Katharina: Soulfood - Vegan, gesund und glücklichSoulfood - Vegan, gesund und glücklich , Das aromenreiche Kochbuch mit 120 Rezepten , Zündvorrichtungen > Zünd- & Glühanlagen , Erscheinungsjahr: 20231017, Produktform: Leinen, Autoren: Küllmer, Katharina, Seitenzahl/Blattzahl: 303, Keyword: Aromenfeuerwerk; Foodfotografie; Gemüse; Gemüseküche; Geschmacksexplosion; Kochbuch vegan; Obst; Plant based Buch; Plant based Kochbuch; Regenbogenküche; Soulfood; aromenreich; aufwändig kochen; besondere Aromen; besondere Kochbücher; besonders kochen; bunt kochen; comfort food; delicious; gesund Kochen; gesunde Ernährung; gesunde Rezepte; katharinaküllmer; kein Fisch; kein Fleisch; laktosefrei; lecker vegan; mit Obst kochen; new cooking; no fish; no meat; pflanzenbasiert; pflanzenbasierte Ernährung; plant based; slow baking; slow cooking; vegan; vegan lecker; vegan und gesund; vegane Ernährung; veganer Genuss; veganes kochbuch, Fachschema: Kochen / Allgemeines Kochbuch, Grundwissen~Kochen / Biologisch, alternativ, Trennkost, Vollwertkost~Kochen / vegetarisch, vegan~Veganismus - vegan, Fachkategorie: Kochen: Gesundheit und Vollwertkost~Organic food / organic cookery~Kochen: Rezepte und Anleitungen, Warengruppe: HC/Themenkochbücher, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 297, Breite: 231, Höhe: 30, Gewicht: 1910, Produktform: Gebunden, Genre: Sachbuch/Ratgeber,42,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Sesamöl bioDas Sesamöl bio wirkt umhüllend, kräftigend und wärmend für sensible Menschen. Es unterstützt die Schutzwirkung der Haut, hilft den Wärmehaushalt des Körpers zu halten und ist ein sehr gutes Massageöl für Wohlfühl-Massagen. Sesamöl dient als bewährtes Hautöl für verschiedene Kuranwendungen im Ayurveda. Unser Sesamöl ist kaltgepresste, naturbelassene Bio Qualität. Die mögliche natürliche Trübung ist ein Zeichen von Naturbelassenheit des Öls.8,91 €*Versand: 3,90 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.